 На карте
Давно собираюсь сделать себе нормальный локальный RAG: чтобы можно было задавать вопросы своим материалам и получать ответы с опорой на них. И вот отличный подгон от Google для этой задачи.
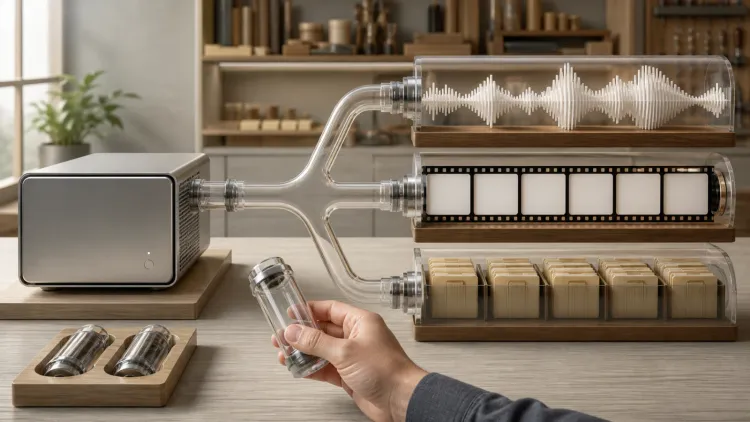
6 октября Google выпустила EmbeddingGemma 2 — маленькую модель для поиска по смыслу. Она работает с текстом, кодом, изображениями, видео и аудио.
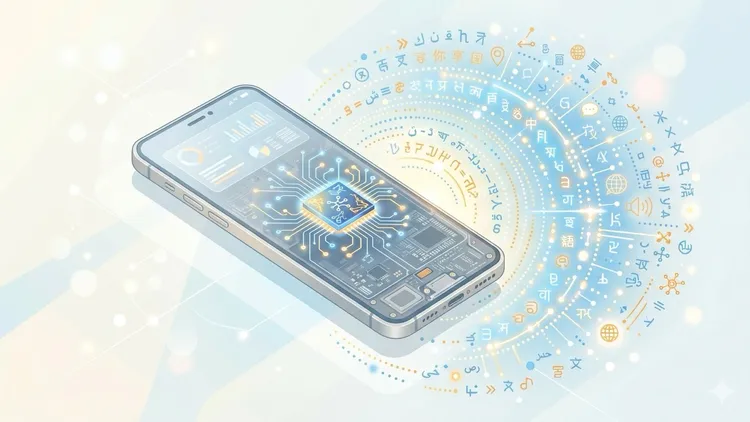
Главное — она рассчитана на локальный запуск даже на смартфонах. Например, готовая сжатая сборка для LiteRT занимает на диске около 485 МБ.
В замерах Google на Pixel 11 Pro сжатый вариант использует около 191 МБ активной оперативной памяти для текстовых весов и около 567 МБ для полной мультимодальной модели. К этому добавится память для приложения, поискового индекса и модели, которая будет составлять ответы.
EmbeddingGemma превращает запросы и материалы в числовые представления — эмбеддинги, которые можно сравнивать по смыслу. Например, текстовым запросом искать нужный фрагмент записи встречи или подходящее изображение, даже если названия файлов ничего не подсказывают.
В RAG она отвечает за поиск: находит подходящие части архива. Затем генеративная модель составляет ответ с опорой на найденное. Google предлагает использовать для этого Gemma 4. Если индекс и обе модели работают локально, документы можно обрабатывать без отправки в облако.
Веса уже доступны на Hugging Face, лицензия — Apache 2.0. Можно начать с текстовой части модели, а обработку изображений и звука подключить позже.
Google заодно представила AI Edge Foresight — экспериментальное приложение для Mac на EmbeddingGemma 2 и Gemma 4. Оно помогает вести заметки на встречах и искать по личным файлам, заметкам и расшифровкам, обрабатывая данные локально.
Для моего будущего RAG это очень кстати: поиск по собственному архиву можно строить на компактной модели, которая помещается даже в телефон.
Следующий шаг
Для генерации ответов в локальном RAG понадобится языковая модель. Вот руководство по запуску Gemma 4 E2B.
Локальную базу знаний полезно начинать с конкретных вопросов, ответы на которые вы хотите находить в своём архиве.
Если захотите обсудить, как это применить у себя или в команде — пишите в Telegram @pimenov