 На карте
Hugging Face можно использовать из своей программы: отправить учебную заметку облачной модели и получить короткую выжимку. Для этого нужны поддерживаемая пара «модель — провайдер», токен с правом вызова Inference Providers и понимание того, кто оплачивает запрос. Скачивать веса модели на компьютер не требуется.
В этом руководстве вы проверите доступность модели, подготовите полный Python-запрос, разберётесь с ответом и ошибками. Начать можно без токена: локальный пример ниже показывает разбор синтетического ответа без обращения к API.
Основа материала: официальная документация и локальные проверки при подготовке, 4 октября 2026 года. Настоящий запрос к модели не выполнялся; доступ конкретного аккаунта, фактическая цена, задержка и качество модели не проверены. Примеры с реальным API — следующий самостоятельный этап, который может расходовать кредиты или деньги.
Что выполняется в облаке
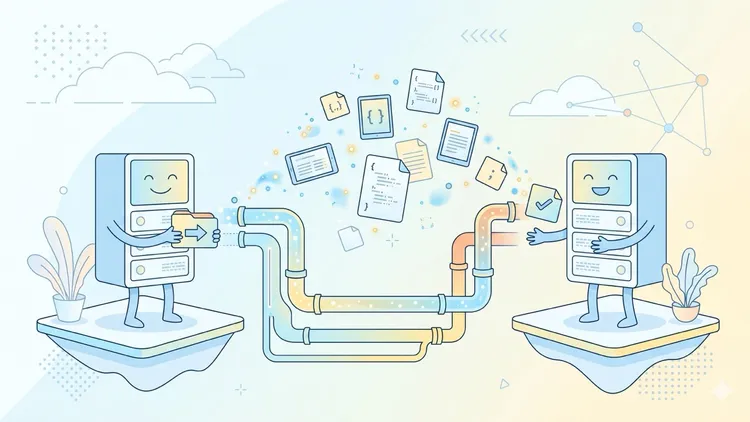
Inference Providers — слой доступа к моделям, которые обслуживают разные провайдеры. В рассматриваемом примере Python-клиент обращается к маршрутизатору Hugging Face, а генерацию выполняет Groq. Компьютер отправляет текст и принимает ответ. Модель и GPU находятся у провайдера. Документация Inference Providers.
Редакционная схема методики. Она не изображает выполненное испытание или ответ модели.
Здесь модель — openai/gpt-oss-120b, а провайдер — groq. openai в model ID обозначает владельца репозитория модели. Сам по себе этот префикс не означает, что запрос отправляется в OpenAI API или оплачивается через OpenAI.
У Hugging Face также есть Inference Endpoints для отдельно развёрнутых сервисов и Spaces для приложений с интерфейсом. У них свои ресурсы и условия оплаты. В этом руководстве используется именно Inference Providers.
Что можно сделать через API
| Задача | Как обращаться | Что проверить до вызова |
| Выжимка, перевод, вопросы по тексту | Chat completion, массив messages | Поддержку conversational и выбранного провайдера |
| Классификация, эмбеддинги, ранжирование | Метод SDK для нужной задачи | Task модели и провайдерскую реализацию |
| Изображение, речь, распознавание аудио | Соответствующий метод InferenceClient | Поддержку формата и отдельную цену операции |
Общий endpoint chat completion подходит для чат-моделей. Нельзя заменить в нём model ID на произвольную модель распознавания речи и ожидать, что запрос заработает. Для других задач используйте их отдельные примеры в официальном списке задач.
1. Проверьте модель и провайдера
На странице модели откройте блок Inference Providers. Наличие файлов модели на Hub ещё не означает, что её можно вызвать у выбранного провайдера. Прочитайте model card, условия использования и требования к доступу; для gated-моделей может понадобиться отдельно принять условия. Поиск по провайдерам, страница выбранной модели.
Публичный GET позволяет проверить mapping без токена и без генерации:
curl --fail --silent --show-error \
  'https://huggingface.co/api/models/openai/gpt-oss-120b?expand=inferenceProviderMapping' \
  -o model-mapping.json

python3 - <<'PY'
import json
with open("model-mapping.json") as source:
    model = json.load(source)
mapping = model.get("inferenceProviderMapping", {})
provider = mapping.get("groq")
if not provider:
    raise SystemExit("Groq не найден: перечитайте текущую поддержку модели")
print({key: provider.get(key) for key in ("status", "task", "providerId")})
if provider.get("status") != "live" or provider.get("task") != "conversational":
    raise SystemExit("Пара модель/провайдер не подходит для этого примера")
PY
На 4 октября 2026 года для Groq получены status: live, task: conversational, providerId: openai/gpt-oss-120b. Это подтверждает запись в каталоге, но не доступ вашего токена или успешную генерацию. Hub API, публичный mapping.
Второй публичный каталог — GET https://router.huggingface.co/v1/models. Он содержит доступные чат-модели, сведения о провайдерах, контекстном окне и ценах. Сверяйте пару перед платной проверкой: состав каталога меняется. Значения задержки и скорости из этого каталога являются метаданными сервиса, а не вашим измерением. Chat completion.
2. Выберите SDK и маршрут
Проверенные по официальным реестрам версии на 4 октября 2026 года:
| Вариант | Пакет и версия | Назначение |
| Python SDK Hugging Face | huggingface-hub==2.1.1 | Chat completion и другие поддерживаемые задачи |
| JavaScript SDK Hugging Face | @huggingface/inference@4.13.30 | Серверный JavaScript, доступ через InferenceClient |
| Совместимый Python-клиент OpenAI | openai==3.24.0 | Chat completion через OpenAI-совместимый HF endpoint |
Для Python-пакетов в таблице требуется Python 3.10+. В локальном примере установлен только SDK Hugging Face; JavaScript и OpenAI SDK проверены по metadata, их выполнение не тестировалось. PyPI huggingface-hub, PyPI openai, официальный JavaScript SDK.
Далее используется InferenceClient. Провайдер задан явно: provider="groq". Это помогает воспроизвести маршрут и проверить расходы. В текущем SDK автоматический выбор auto может выбирать провайдера и переключаться при сбое; универсальный router также поддерживает политики :fastest, :cheapest, :preferred. В учебном запросе автоматическая смена маршрута не нужна. Выбор провайдера.
Для прямого HTTP-запроса chat completion используется:
POST https://router.huggingface.co/v1/chat/completions
Authorization: Bearer <HF_TOKEN>
Content-Type: application/json

{"model":"openai/gpt-oss-120b:groq","messages":[{"role":"user","content":"Учебный текст"}],"max_tokens":256,"stream":false}
Это схема запроса, а не команда для автоматического запуска. Значение <HF_TOKEN> — обозначение секрета, не готовый ключ. Для OpenAI SDK базовый URL — https://router.huggingface.co/v1, а ключом служит HF-токен. Официальный пример HTTP и SDK.
У HF SDK при явно выбранном Groq свой провайдерский путь: в локальном transport-тесте версии 2.1.1 сформирован POST https://router.huggingface.co/groq/openai/v1/chat/completions. SDK строит его сам; вручную заменять endpoint внутри клиента не требуется. Этот тест перехватил запрос в памяти и не отправлял его в интернет. Старые примеры с api-inference.huggingface.co/models/... не переносите в данный chat completion без проверки текущей документации.
3. Подготовьте токен без лишних прав
Этот шаг нужен только для реального запроса. В подготовке материала токен не создавался и настройки аккаунта не менялись.
В настройках токенов создайте отдельный fine-grained токен для приложения. Для публичной модели из примера требуется право Make calls to Inference Providers. Не включайте права изменения репозиториев, создания ресурсов и администрирования: этот запрос их не использует. Если модель закрытая или gated, отдельно проверьте доступ к ней и требуемые права чтения ресурса. User access tokens, права для chat completion.
Передайте токен в переменную окружения серверного процесса HF_TOKEN. Не помещайте его в Python-файл, браузерный JavaScript, URL, снимок экрана или Git. Файл .env допустим как локальное хранилище вне Git, но программа должна явно его загружать. Пример ниже читает окружение и не загружает .env автоматически.
В macOS zsh можно ввести токен без отображения и без добавления значения в историю команд:
read -r -s 'HF_TOKEN?HF_TOKEN: '
export HF_TOKEN
Не проверяйте значение через echo, env или отладочный вывод headers. Для этого примера не нужен hf auth login: токен передаётся клиенту явно, а не берётся из сохранённого входа.
4. Сначала разберите ответ без API
Для этой проверки достаточно Python 3; токен и дополнительные пакеты не нужны. Скопируйте команду целиком в терминал:
python3 - <<'PYCODE'
import json

# Синтетический пример: это не ответ модели и не измерение расхода.
raw = '{"choices":[{"message":{"content":"• Встреча назначена на пятницу.\\n• Анна подготовит список растений."},"finish_reason":"stop"}],"usage":{"total_tokens":120}}'
answer = json.loads(raw)
choice = answer["choices"][0]
text = choice["message"]["content"]
assert isinstance(text, str) and text.strip()
assert choice["finish_reason"] == "stop"
print("УЧЕБНЫЙ ПРИМЕР · без сети и API")
print(text)
print("Причина остановки:", choice["finish_reason"])
print("Условный счётчик токенов:", answer["usage"]["total_tokens"])
PYCODE
Должны появиться два пункта, причина остановки stop и условное число 120. Это число задано в примере для знакомства со структурой JSON. Оно не подтверждает цену, качество модели или реальный расход токенов.
При подготовке исходного примера также прошли 22 локальных теста с запретом сетевых соединений: валидация, явное включение API, SDK-запрос через подменённый transport, ошибки и timeout. Реальный провайдер в этих проверках не участвовал.
5. Полный пример одного реального запроса
Следующий код сохраните как first_request.py в своей рабочей папке. Установите в её venv huggingface-hub==2.1.1. Он отправляет одну синтетическую заметку, ограничивает вывод, показывает текст ответа и очищает сообщения об ошибках. По умолчанию запрос заблокирован.
python3 -m venv .venv
.venv/bin/python -m pip install 'huggingface-hub==2.1.1'
import os
import sys

import httpx2
from huggingface_hub import InferenceClient
from huggingface_hub.errors import HfHubHTTPError, InferenceTimeoutError

MODEL = "openai/gpt-oss-120b"
PROVIDER = "groq"
TEXT = (
    "Учебная команда готовит встречу о городском саде. "
    "Встречу назначили на пятницу, список растений подготовит Анна. "
    "В четверг участники проверят, хватает ли семян."
)


def main():
    if os.getenv("HF_ALLOW_PAID_API") != "1":
        print("API выключен: сначала определите маршрут и допустимый расход")
        return 2
    token = os.getenv("HF_TOKEN", "").strip()
    if not token:
        print("API выключен: HF_TOKEN отсутствует в окружении")
        return 2
    try:
        with InferenceClient(
            provider=PROVIDER, api_key=token, timeout=30.0
        ) as client:
            answer = client.chat.completions.create(
                model=MODEL,
                messages=[
                    {"role": "system", "content": (
                        "Сделай выжимку на русском: до трёх пунктов, "
                        "только факты из учебного текста."
                    )},
                    {"role": "user", "content": TEXT},
                ],
                max_tokens=256,
                stream=False,
            )
        if not answer.choices:
            print("Ответ без choices: проверьте модель и формат")
            return 1
        choice = answer.choices[0]
        content = choice.message.content
        if not isinstance(content, str) or not content.strip():
            print("Пустой текст: проверьте модель и лимит ответа")
            return 1
        print(content.strip())
        print("finish_reason:", choice.finish_reason)
        if answer.usage is not None:
            print("usage:", answer.usage)
        return 0
    except (InferenceTimeoutError, httpx2.TimeoutException):
        print("Timeout: проверьте usage и расходы до повторного запроса")
    except HfHubHTTPError as error:
        code = error.response.status_code if error.response is not None else 0
        print(f"HTTP {code}: используйте таблицу ошибок; headers и тело скрыты")
    except httpx2.RequestError:
        print("Сетевая ошибка: проверьте соединение без автоматического повтора")
    except (ValueError, TypeError, KeyError, AttributeError):
        print("Не удалось разобрать ответ: проверьте совместимость SDK")
    except Exception:
        print("Ошибка клиента: детали скрыты; проверьте версии и конфигурацию")
    return 1


if __name__ == "__main__":
    sys.exit(main())
Код использует HTTP-слой httpx2, который входит в зависимости проверенной версии SDK. InferenceTimeoutError импортируется из huggingface_hub.errors. Не переносите импорты из старых примеров без сверки установленной версии. Справочник InferenceClient.
После проверки провайдера, источника биллинга и допустимого расхода задайте флаг и выполните скрипт один раз:
export HF_ALLOW_PAID_API=1
.venv/bin/python first_request.py
unset HF_ALLOW_PAID_API HF_TOKEN
Флаг — подтверждение намерения внутри примера. Он не задаёт денежный лимит Hugging Face. Каждый новый запуск скрипта может создать ещё один оплачиваемый запрос.
Как читать ответ
При stream=False SDK возвращает объект целого ответа. Основные поля:
| Поле | Что означает | Как использовать |
choices[0].message.content | Текст первого ответа | Проверить, что choices есть, а content — непустая строка |
choices[0].finish_reason | Причина завершения | При length не считать результат полным |
usage.prompt_tokens | Учтённые входные токены, если поле возвращено | Использовать для оценки расхода |
usage.completion_tokens | Учтённые выходные токены | Сверить с тарифом выбранного маршрута |
usage.total_tokens | Суммарное значение | Не путать с ценой в долларах |
Формат chat completion описан в документации Hugging Face. Пустой content возможен и при формально успешном HTTP-ответе. У reasoning-моделей часть лимита может уйти на внутреннее рассуждение. max_tokens=256 — небольшой учебный предел; он не гарантирует, что любая модель успеет выдать три пункта.
После настоящего запроса проверьте, что ответ основан на исходном тексте, не придумывает сроки и людей, а finish_reason не указывает обрезание. Затем откройте usage и billing аккаунта. Только такой read-back подтверждает работающий API и расход; локальный fixture этого не делает.
Полезные сценарии
Выжимка из короткой заметки
Задача — быстро увидеть основные факты перед встречей. Подготовьте учебную заметку длиной до 2000 символов, отправьте её с инструкцией «до трёх пунктов, только факты из текста». Проверка результата: каждый пункт можно указать в оригинале; новых обещаний и дат нет. Смысловая выжимка модели требует реального вызова; синтетический пример выше проверяет только разбор ответа.
Для конфиденциальных заметок сначала оцените правила передачи данных обоих сервисов. Сам факт серверного вызова не даёт права отправлять туда клиентскую информацию.
Черновой перевод короткого технического описания
Задача — подготовить русскую версию описания функции. В messages замените system-инструкцию на «Переведи описание на русский; сохрани названия функций и параметры без изменений», а user-текст — на небольшой синтетический абзац. Маршрут и разбор ответа остаются теми же. Проверка: сравните названия, числа, отрицания и условия с оригиналом. Перевод договора, медицинского текста или неизвестной терминологии требует отдельной содержательной проверки; этот пример её не заменяет.
Это второй способ применить тот же интерфейс API, а не результат выполненного в подготовке теста модели. Каждый реальный запуск снова расходует запрос.
Сколько это стоит и как остановить расход
Условия ниже проверены 5 октября 2026 года. Перед запуском перечитайте Pricing and Billing и свою страницу billing.
| Режим | Кто оплачивает | Как учитываются включённые кредиты |
| Routed by Hugging Face, без собственного ключа провайдера | Ваш HF-аккаунт | Кредиты применяются к подходящему использованию |
| Custom Provider Key в настройках HF | Аккаунт у провайдера | HF-кредиты не применяются |
Запрос с bill_to / X-HF-Bill-To | Явно указанная организация | Нужны соответствующий доступ и условия организации |
Для free user документация указывает $0.10 в месяц, subject to change. PRO получает $2 в месяц общих compute credits; Team/Enterprise — $2 на место. Для платных планов эти кредиты могут расходоваться также на другие compute-сервисы HF. После включённых кредитов дополнительное использование требует приобретённых кредитов. Hugging Face заявляет отсутствие своей наценки на routed inference. Текущие условия.
Ключ провайдера может быть настроен в аккаунте HF, и код с HF-токеном при этом останется прежним: маршрутизатор подставит ключ. Поэтому один только Python-файл не доказывает источник биллинга. Перед запуском проверьте настройки Inference Providers; не меняйте их заодно с тестом без понимания последствий.
В публичном router-каталоге на дату проверки для openai/gpt-oss-120b у Groq указаны $0.15 за миллион входных и $0.75 за миллион выходных токенов. Это текущая запись каталога для выбранного маршрута, а не универсальная цена GPT OSS. Каталог router, структура каталога и единицы цен.
Условная оценка для 1000 входных и 200 выходных токенов:
(1000 × 0.15 + 200 × 0.75) / 1 000 000 = $0.00030
Это арифметический пример, не измеренный расход. Точная сумма зависит от учтённых токенов, тарифа и правил провайдера. Число символов и число токенов различаются; 2000 символов валидации — не 2000 токенов. Для других задач цена может считаться по изображению, аудио или времени вычисления.
Перед первым вызовом зафиксируйте model ID, провайдера, источник оплаты и максимальный приемлемый расход. Ограничьте вход и вывод, запустите один запрос, затем проверьте usage и billing. При timeout не нажимайте повтор автоматически: сервер мог выполнить работу, пока клиент перестал ждать. Пример не делает автоматического повтора и не переключает провайдера.
У Inference Providers нет единого подходящего для всех аккаунтов RPM-лимита. Лимиты зависят от провайдера, модели и аккаунта; HTTP 429 нужно разбирать по текущим условиям своего маршрута. Лимиты чтения Hub API — отдельная категория и не гарантируют квоту inference. Rate limits Hub.
Что делать при ошибке
| Симптом | Что проверить | Следующее действие |
| API выключен до запроса | HF_ALLOW_PAID_API, наличие HF_TOKEN | Оставить выключенным до решения о расходах; секрет не печатать |
| 401 | Токен отсутствует, недействителен или отозван | Проверить токен в аккаунте, не расширяя права вслепую |
| 402 | Кредиты и режим оплаты | Проверить billing, не повторять в цикле |
| 403 | Право Inference Providers и gated/private доступ | Сверить точную модель и права токена |
| 404 / unsupported model | Model ID, task, provider mapping | Повторить только публичный GET, затем исправить выбор |
| 429 | Квота или частота запросов | Остановить повтор, проверить ограничения провайдера |
| 5xx | Ошибка HF или провайдера | Сверить статус сервисов и usage до новой попытки |
| Timeout / сетевая ошибка | Соединение, доступность route, время ожидания | Сначала проверить результат и расход, затем решить о повторе |
200, но пустой текст / length | Совместимость модели и предел вывода | Не считать запрос успешным по HTTP-коду; оценить новый лимит до повтора |
| Ошибка импорта SDK | Версия Python, активная venv, пакет | Запускать через .venv/bin/python, сверить 2.1.1 и импорты |
Тела исключений и headers могут содержать служебные данные. Пример выводит тип ошибки и HTTP-код без этих деталей. Для диагностики сохраняйте время, model/provider и код ответа, а не токен или исходную конфиденциальную заметку.
Hugging Face описывает свои правила хранения и диагностики routed requests в Security and Privacy. Провайдер, которому передаются данные, имеет собственные условия. Для реальных пользовательских данных прочитайте и их; заявление HF нельзя автоматически распространить на весь маршрут.
Что подтверждено в этом руководстве
Подтверждены актуальные версии пакетов, публичная поддержка выбранной пары и условия в официальной документации. Локально проверены синтетический ответ, валидация и настоящий код SDK с подменённым transport. Не проверены настоящий токен, генерация, качество модели, фактическая задержка, расходы и доступность для конкретного аккаунта или страны.
Для проверки текущих сбоев доступны статус Hugging Face и официальный форум. Текущий статус аккаунта и провайдера проверяйте перед настоящим вызовом.
Сохранить код и историю проекта помогут руководства GitHub; размещение интерфейса и облачных сервисов разобрано в спецпроекте Cloudflare.
Серия Hugging Face
Все руководства: Hugging Face на практике. Маршрут: 1. Обзор платформы · 2. Готовые приложения Spaces · 3. Выбор модели · 4. Запуск в LM Studio · 5. Сравнение моделей · 6. Первый запрос по API — вы здесь
Следующий шаг
Hugging Face Spaces: как найти ИИ-приложение и попробовать его без установки — чтобы увидеть, как похожая функция выглядит для пользователя в браузере.
При подключении модели к своему инструменту полезно заранее определить, какие данные уходят в облако и кто оплачивает запросы. Такой разбор помогает проверить небольшой сценарий до распространения его на всю команду.
Если захотите обсудить, как это применить у себя или в команде — пишите в Telegram @pimenov